

线性表
由n(n>=0)个数据特性相同的元素构成的有限序列,称为线性表。即,线性表是n个数据元素的有限序列,其中n个数据是相同数据类型的。
存在唯一一个“第一个”的数据元素(头节点)。
存在唯一一个“最后一个”的数据元素(尾节点)。
除了第一个元素外,结构中每个数据元素均只有一个前驱。
除了最后一个元素外,结构中每个数据元素均只有一个后继。
顺序表
顺序表是线性表当中的一种,用一组连续的内存单元依次存储线性表的各个元素,也就是说,逻辑上相邻的元素,实际的物理存储空间也是连续的。我们可以知道,数组在逻辑上是符合顺序表的定义的。
初始化顺序表:
#define AAA=100
typedef int INTAAA;

typedef struct
{
  INTAAA data[AAA];
  int length;
}SeqList;

void initList(SeqList* L)
{
  L->length = 0;
}
初始化顺序表(动态分配内存):
#define AAA=100
typedef int INTAAA;

typedef struct
{
  INTAAA* data;
  int length;
}SeqList;

SeqList* initList()
{
  SeqList* L = (SeqList*)malloc(sizeof(SeqList));
  L->data = (INTAAA*)malloc(sizeof(INTAAA) * AAA);
  L->length = 0;
  return L;
}
在尾部添加元素:
int appendElem(SeqList* L,INTAAA e)
{
  if (L->length>=AAA)
  {
    printf("顺序表已满\n");
    return 0;
  }
  L->data[L->length] = e;
  L->length++;
  return 1;
}
顺序表遍历:
void listElem(SeqList* L)
{
  for(int i = 0; i< L->length;i++)
  {
    printf("%d ",L->data[i]);
  }
  printf("\n");
}
顺序表插入元素:
int insertElem(SeqList* L,int pos,INTAAA e)
{
  if(pos <= L->length)
  {
    for(int i = L->length-1; i>=pos-1 ; i--)
    {
      L->data[i+1] = L->data[i];
    }
    L->data[pos-1] = e;
    L->length++;
  }
  return 1;
}
顺序表删除元素(注:e是用来保存被删除的元素,用于返回给调用者,不需要返回可删除):
int deleteElem(SeqList* L,int pos,INTAAA* e)
{
  *e = L->data[pos-1];
  if(pos < L->length)
  {
    for(int i =pos ; i<L->length;i++)
    {
      L->data[i-1] = L->data[i];
    }
  }
  L->length--;
  return 1;
}
顺序表查找:
int findElem(SeqList* L,INTAAA e)
{
  for(int i = 0; i<L->length;i++)
  {
    if(L->data[i] == e)
      {
        return i+1;
      }
  }
  return 0;
}
链表
链表的存储单元不像顺序表那样是需要连续的,链表的存储单元可以是连续的,也可以是不连续的。
单链表
typedef int INTAAA;

typedef struct node
{
  INTAAA data;
  struct node* next;
}Node;
单链表初始化(头节点):
Node* initList()
{
  Node* head = (Node*)malloc(sizeof(Node));
  head->data = 0;
  head->next = NULL;
  return head;
}

int main()
{
  Node* list = initList();
  return 1;
}
单链表插入数据(头插法):
int insertHead(Node* L,INTAAA e)
{
  Node* p = (Node*)malloc(sizeof(Node));
  p->data =e;
  p->next = L->next;
  L->next = p;
}

int main()
{
  Node* list = initList();
  insertHead(list,10);
  insertHead(list,20);
}
单链表遍历:
void listNode(Node* L)
{
  Node* p = L->next;
  while(p!=NULL)
  {
    printf("%d\n",p->data);
    p = p->next;
  }
  printf("\n");
}
单链表插入数据(尾插法):
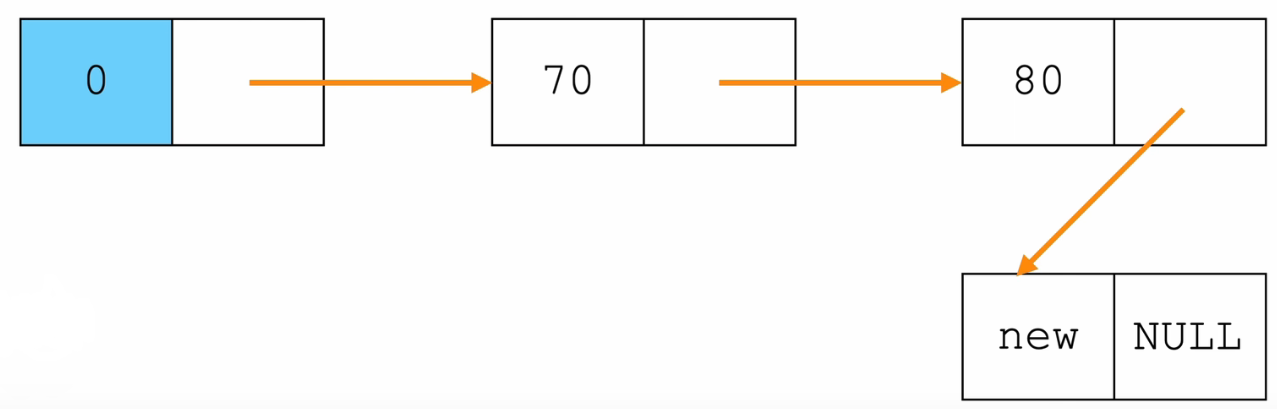
头插法跟输入的数据是相反的,比如咱们依次插入10、20、30,输出的是30、20、10,这时我们可以通过尾插法来规避这个情况。
尾插法和头插法不同,头插法可以很轻松的找到头节点,但尾插法无法直接找到尾节点,所以我们需要先找到尾节点。
Node* Get_tail(Node* L)
{
  Node* p =L;
  while(p->next !=NULL)
  {
    p=p->next;
  }
return p;
}
Node* insertTail(Node* tail,INTAAA e)
{
  Node* p =(Node*)malloc(sizeof(Node));
  p->data = e;
  tail->next = o;
  p->next = NULL;
  return p;
}
单链表插入(指定位置插入):
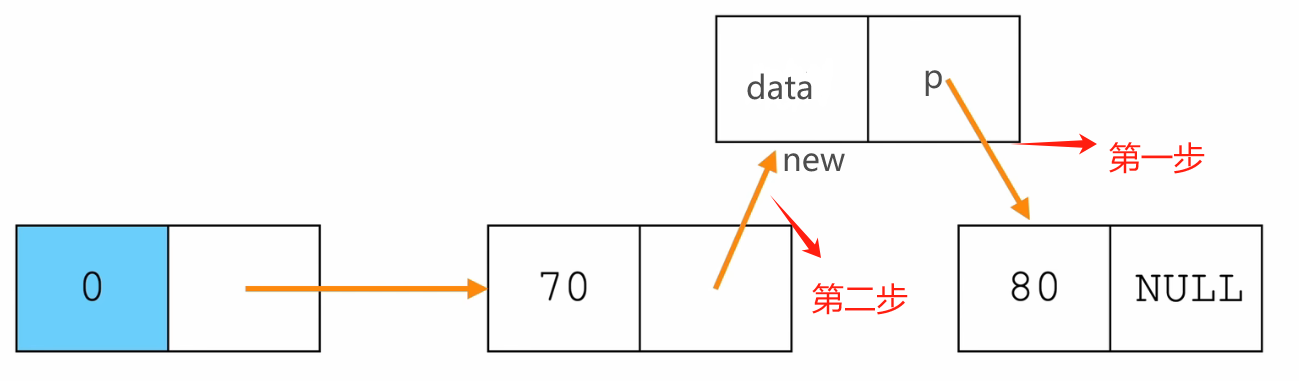
注意顺序不要反,否则指向存储80数据的节点的地址会被覆盖!
int insertNode(Node* L,int pos,INTAAA e)
{
  Node* p = L;//L是头节点
  int i = 0;
  while(i<pos-1)//循环至我们要插入的前一个节点
    {
      p = p->next;
      i++;
      if(p == NULL)
        {
          return0;
        }
    }

  Node* q = (Node*)malloc(sizeof(Node));
  q->data = e;
  q->next = p->next;
  p->next =q;
  return 1;
}
单链表删除节点:
要删除一个节点,首先要找到要删除的这个节点的上一个节点,用指针q来记录要删除的节点(因为要释放这个删除的节点,所以需要记录一下)
int deleteNode(Node* L,int pos)
{
  Node* p = L;
  int i = 0;
  while(i<pos-1)
  {
    p = p->next;
    i++;
    if(p == NULL){ return 0;}
  }
  if(p->next == NULL)
  {
    printf("要删除的位置错误!\n");
    return 0;
  }
//q指向要删除的节点,一会释放
  Node *q = p->next;
//让要删除节点的前驱指向要删除节点的后继
  p->next =q->next;
  free(q);
  return 1;
}
单链表获取链表长度:
int listLength(Node* L)
{
  Node* p =L;
  int len = 0;
  while(p->next != NULL)
  {
    p=p->next;
    len++;
  }
  return len;
}
单链表释放链表:
void freeList(Node* L)
{
  Node* p = L->next;
  Node* q;

  while(p!= NULL)
  {
    q= p->next;
    free(p);
    p = q;
  }
  L->next = NULL;
}
练习
1.已知一个带有表头节点的单链表,节点结构为
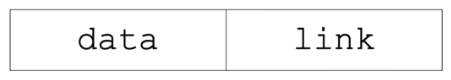
假设该链表只给出了头指针 list 。在不改变链表的前提下,请设计一个尽可能高效的算法,查找链表中倒数第k个位置上的结点(k为正整数)。若查找成功,算法输出该节点的 data 域的值,并返回1;否则,只返回 0 。
要求:
1)描述算法的基本思想;
2)描述算法的详细实现步骤;
3)根据设计思想和实现步骤,采用程序设计语言描述算法(使用C、C++、或 Java语言实现),关键之处请给出简要注释。
经典思路(双指针):
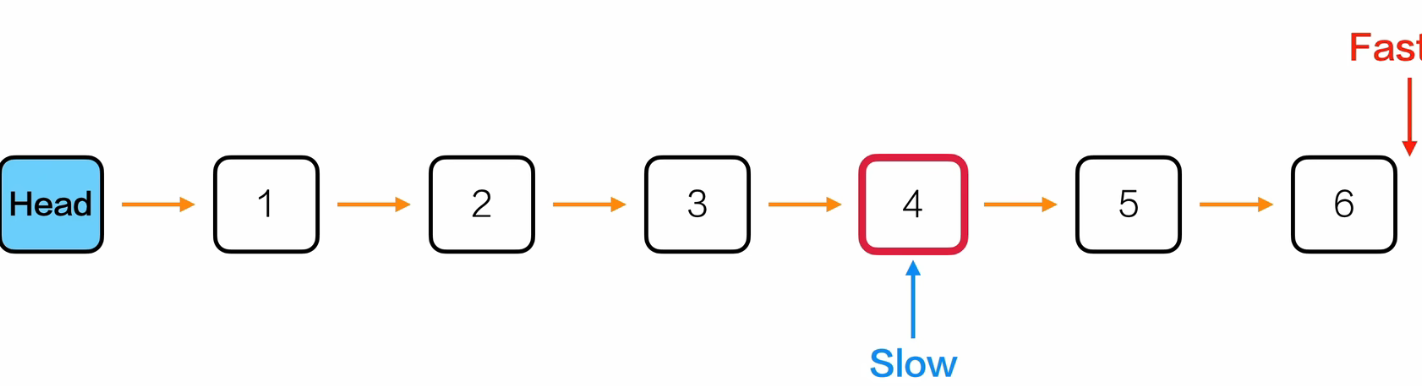
通过快慢指针来进行,即构建两个指针,第一个指针我们把它叫做快指针,第二指针我们把它叫做慢指针,假设k是3,我们就让快节点先走3步:
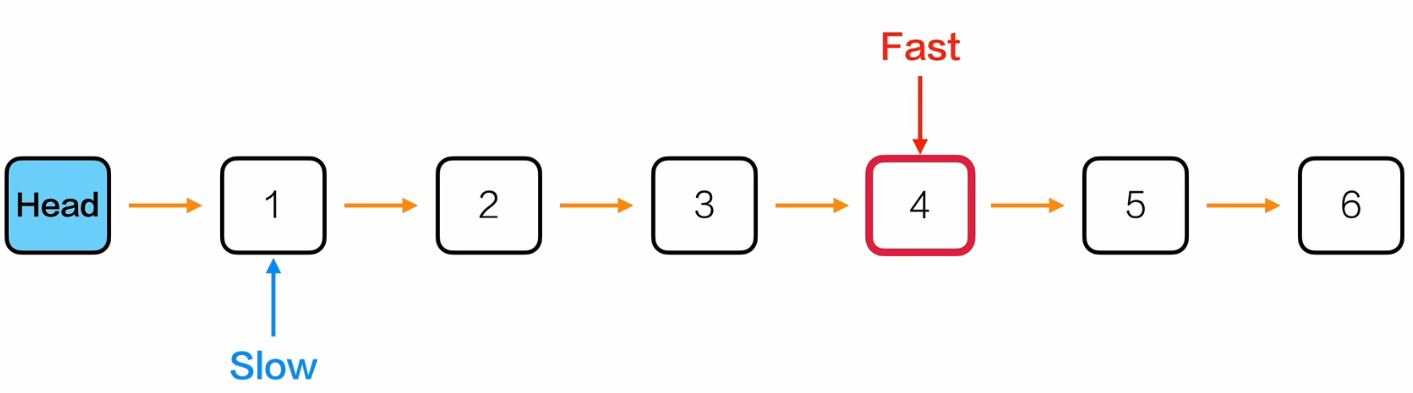
然后快节点和慢节点再一起走,当快指针的下个指针为NULL时,此时慢指针恰好为倒数第K个指针:
typedef struct Node {
    int data;
    struct Node* link;
} Node;

int findNodeFS(Node* L, int k) {
    // 检查链表是否为空,或者链表无数据结点(头结点后为空)
    if (L == NULL || L->link == NULL) {
        printf("链表为空或无数据结点!\n");
        return 0;
    }

    // 初始化快慢指针,均从第一个有效数据结点开始
    Node* fast = L->link;
    Node* slow = L->link;

    // 快指针先移动 k 步
    for (int i = 0; i < k; i++) {
        if (fast == NULL) {  // 若链表数据节点数小于 k,直接返回失败
            printf("链表中的数据节点不足 %d 个!\n", k);
            return 0;
        }
        fast = fast->link;
    }

    // 同时移动快慢指针,直到快指针到达链表末尾
    while (fast != NULL) {
        fast = fast->link;
        slow = slow->link;
    }

    // 此时 slow 指向倒数第 k 个节点
    printf("倒数第 %d 个节点的值为 %d\n", k, slow->data);
    return 1;
}
个人思路:
首先,我们知道了头链表是list,那么list->link存放的就是第一个节点的地址,而题目要的是倒数第k个位置上的节点,所以我们要从尾节点进行,但我们没有尾节点的地址,所以要先查找尾节点,即获取链表长度:
typedef struct node
{
  int data;
  struct node* link;
}node;

node* list = /* 已经构造好的链表头指针 */;
int k = /* 倒数第K的值 */;

int main()
{
  node* p = list->link; //存储第一个节点
  int len = 0; //len为节点的长度。
//计算出节点的总长度。
  while( p != NULL)
    {
      p = p->link;
      len++;
    }
//判断倒数第k个节点是否在链表上
  if(k>len || k<= 0)
    {
      return 0;
    }

  //将指针移动至倒数K节点的位置
  p = list->link; //p指向第一个节点
  int pos = 1;
  while( pos < len- k+1)
    {
      p = p->link;
      pos++;
    }
  //将data值输出至int kdata中
  int kdata = p->data;
  return 1;
}
2.假定采用带头节点的单链表保存单词,当两个单词有相同的后缀时,则可共享相同的后缀存储空间,例如,“loading”和“being”的存储映像如下图所示。
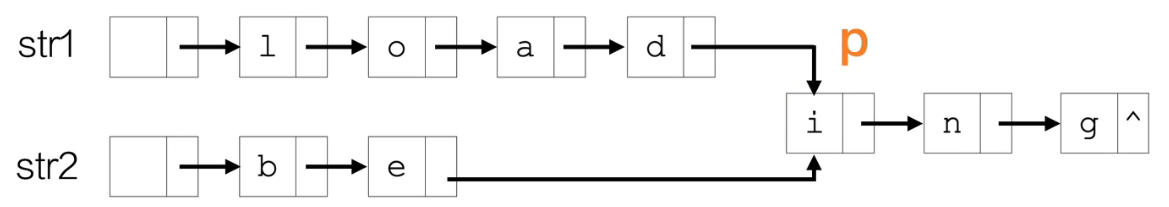
设 str1 和 str2 分别指向两个单词所在单链表的头节点,链表结点结构为 data|next请设计一个时间上尽可能高效的算法,找出由str1和 str2 所指向两个链表共同后缀的起始位置(如图字符i所在结点的位置p)。要求:
1)描述算法的基本设计思想;
2)根据设计思想,采用 C 或 C++ 或 Java 语言描述,关键之处给出注释。
3)说明你所设计算法的时间复杂。
这道题目是说,不同用链表来存储不同单词,但不同单词的后缀若相同,则后缀使用同一部分的链表,然后链表的结构有data和next,典型的单链表结构,这里的data的数据类型明显应该是char类型的,用来存储英文字符,题目又说让其在时间上尽可能高效,意味着不让使用嵌套循环,使用嵌套循环会导致时间复杂度升为O(n²),那么我们可以继续用双指针(快慢指针)的思路来解决这道题目:
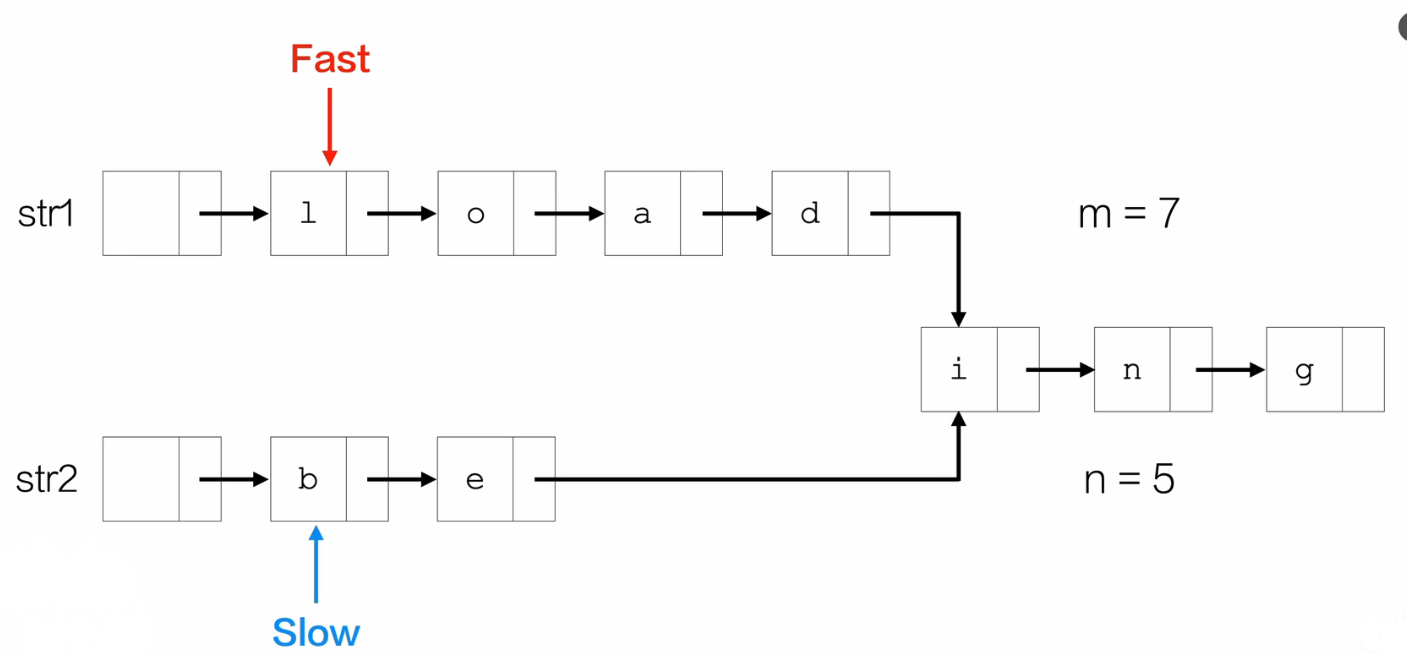
第一步:分别求出两个链表的长度m和n。
第二步:让快指针指向较长的链表,先走m-n或者n-m步。
第三步:同步移动指针,判断他们是否指向同一个节点。
typedef struct node
{
    char data;
    struct node* next;
}Node;

//根据题目所知,str1和str2是头节点。
void Findsfx(Node* str1,Node* str2)
{
    int strleng1 = 0;
    int strleng2 = 0;
    int lengsub = 0;
    int hub = 0;
    Node* p = str1;
    Node* q = str2;
    //先计算两个链表的长度

    while(p->next != NULL)
    {
        p = p->next;
        strleng1++;
    }
    while(q->next != NULL)
    {
        q = q->next;
        strleng2++;
    }

    //判断哪个链表的长度更长,并找出后缀首结点
    if(strleng1>=strleng2)
    {
        lengsub = strleng1 - strleng2;
        hub = 0;
        p = str1->next; //str1链表的第一个结点
        q = str2->next; //str2链表的第一个结点
        while(hub < lengsub)
        {
            p = p->next;
            hub++;
        }
        //此时p已经变成快指针应该在的位置,现在让快慢指针一起移动
        while(p != q)
        {
            p = p->next;
            q = q->next;
        }
        printf("后缀的首结点是%c\n",p->data);
    }else
    {
        lengsub = strleng2 - strleng1;
        hub = 0;
        p = str1->next; //str1链表的第一个结点
        q = str2->next; //str2链表的第一个结点
        while(hub < lengsub)
        {
            q = q->next;
            hub++;
        }
        //此时q已经变成快指针应该在的位置,现在让快慢指针一起移动
        while(p != q)
        {
            p = p->next;
            q = q->next;
        }
        printf("后缀的首结点是%c\n",q->data);
    }


}
3.用单链表保存n个整数,结点的结构为[data][link],且|data|<=n(n 为正整数)。现要求设计一个时间复杂度尽可能高效的算法,对于链表中 data 的绝对值相等的节点,仅保留第一次出现的节点而删除其余绝对值相等的结点。
例如,若给定单链表[head]->[21]->[-15]->[-15]->[7]->[15]
则删除后的节点为 [head]->[21]->[-15]->[7]
要求:
1)给出算法的基本设计思想。
2)使用 C 或 C++语言,给出单链表节点的数据类型定义。
3)根据设计思想,采用 C 或 C++ 语言描述算法,关键之处给出注释。
4)说明你所设计算法的时间复杂度和空间复杂度。
这里我们使用一个新的思想,那就是拿空间换时间,你只需要遍历循环一次这个链表就可以了,就能解决这个问题。
|data|<=n 在这里是什么意思?根据题目可知,n的本意是单链表保存n的个数,|data|<=n是干什么的?意味着如果n最少等于|data|的最大值,所以我们可以使用一个n+1的数组,来标记所有data的出现次数,若大于0,则代表出现过,然后再在链表中执行删除操作:
void removeNode(Node* L, int n)
{
    Node* p = L;
    int index; // 用作数组下标
    int* q = (int*)malloc(sizeof(int) * (n + 1));

    // 遍历数组,将所有元素初始化为0
    for (int i = 0; i < n + 1; i++)
    {
        *(q + i) = 0;
    }

    // 遍历整个链表(注意 p 指向头节点,保留头节点,不处理 head->data)
    while (p->next != NULL)
    {
        // 取当前待检查节点的绝对值,作为数组下标
        index = abs(p->next->data);
        if (*(q + index) == 0)
        {
            // 第一次出现,做标记,然后指针向后移动
            *(q + index) = 1;
            p = p->next;
        }
        else
        {
            // 重复节点:删除 p->next 节点
            Node* temp = p->next;
            p->next = temp->next;
            free(temp);
        }
    }
    free(q);
}
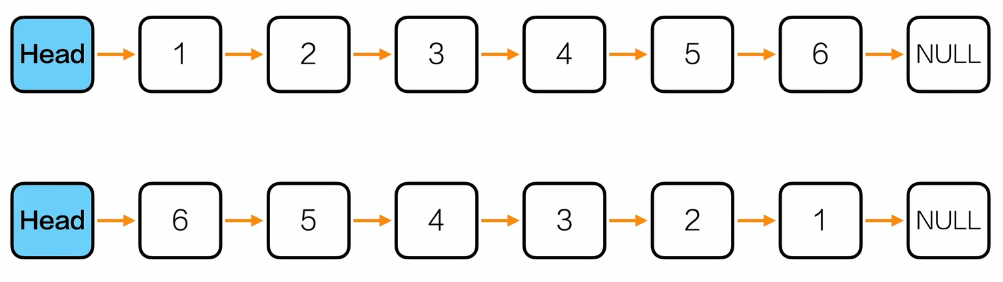
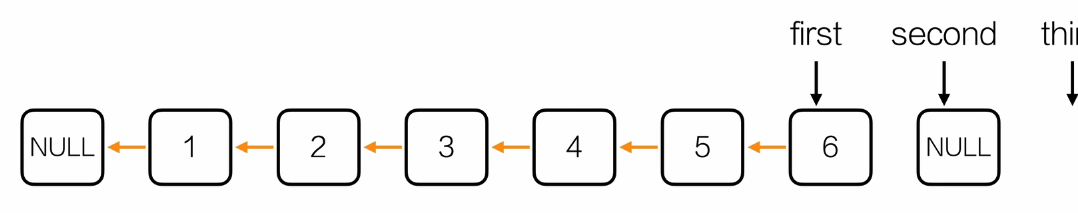
4.反转下列链表
反转链表的套路:
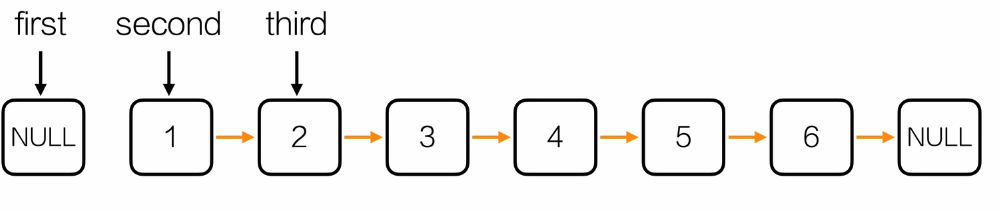
第一步:先拿一个first指向一个空值,再拿一个second指向第一结点,再拿一个third指向second指向的下一个结点。
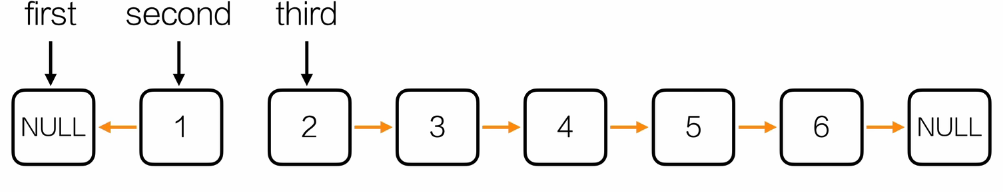
第二步:让second指向空值。
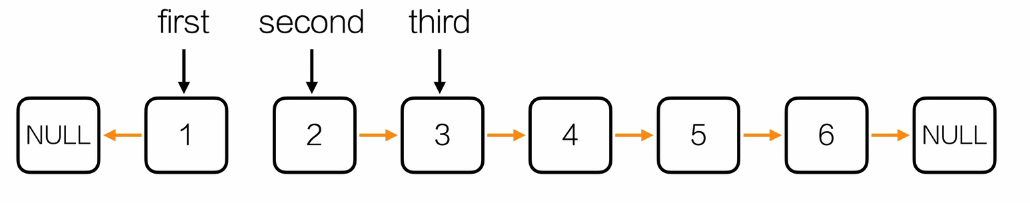
第三步:同时移动first、second、third。
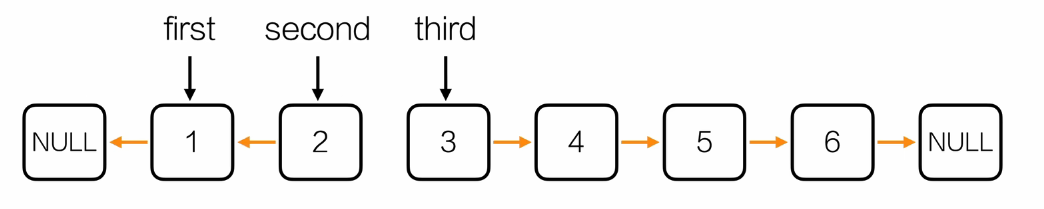
第四步:让second指向前一个结点。
第五步:重复三四步骤直到second走向空值。
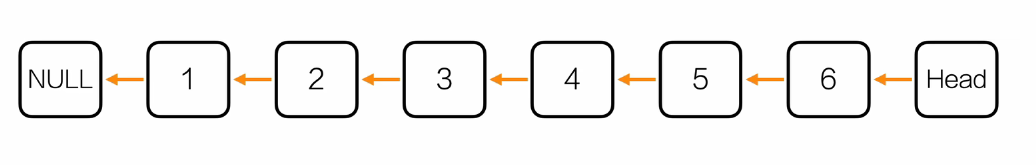
第六步:给链表安装头节点。
typedef struct node
{
    int data;
    struct node* next;
}Node;

Node* initList()
{
    Node* head = (Node*)malloc(sizeof(Node));
    head->data = 0;
    head->next = NULL;
    return head;
}

Node* reverseList(Node* head)
{
    Node* first = NULL;
    Node* second = head->next;
    Node* third ;

    while(second != NULL)
    {
        third = second->next;
        second->next = first;

        first = second;
        second = third;
    }
    Node* hd = initList();
    hd->next = first;
    return hd;
}
5.删除链表中间节点(注:对于偶数,例如123456,那么4算作中间节点)
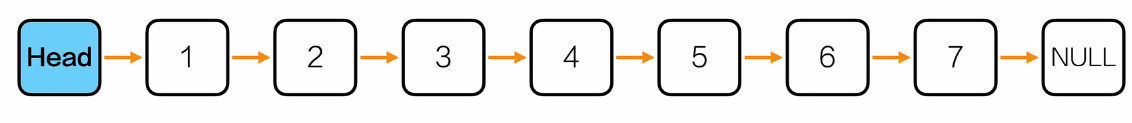
那么这道题,我们还是采用快慢指针的玩法,只不过这个快指针要一次走两步,慢指针一次走一步,这样的话,当快指针的下一个结点是空结点时,慢指针的下一个结点就是我们要删除的中间结点。
typedef struct node
{
    int data;
    struct node* next;
}Node;

int delMiddleNode(Node* head)
{
    Node* fast = head->next;
    Node* slow = head;

    while(fast != NULL && fast->next != NULL)
    {
        fast = fast->next->next;
        slow = slow->next;
    }

    Node* q = slow->next;
    slow->next = q->next;
    free(q);
    return 1;
}