

SPI外设简介
STM32内部集成了硬件SPI收发电路,可以由硬件自动执行时钟生成、数据收发等功能,减轻CPU的负担。就是硬件电路自动生成时序,无需我们自己手动翻转电平。
可配置8位/16位数据帧、高位先行/低位先行。SPI最常用的配置就是:8位数据帧、高位先行。
时钟频率: fPCLK / (2, 4, 8, 16, 32, 64, 128, 256)。时钟频率是fPCLK除以一个分频系数,SPI时钟其实就是由PCLK(外设时钟)分频得来的,APB2的PCLK是72MHz,APB1的PCLK是36MHz。
支持多主机模型、主或从操作。
可精简为半双工/单工通信。
支持DMA 、兼容I2S协议。
STM32F103C8T6 硬件SPI资源:SPI1、SPI2。
SPI框图
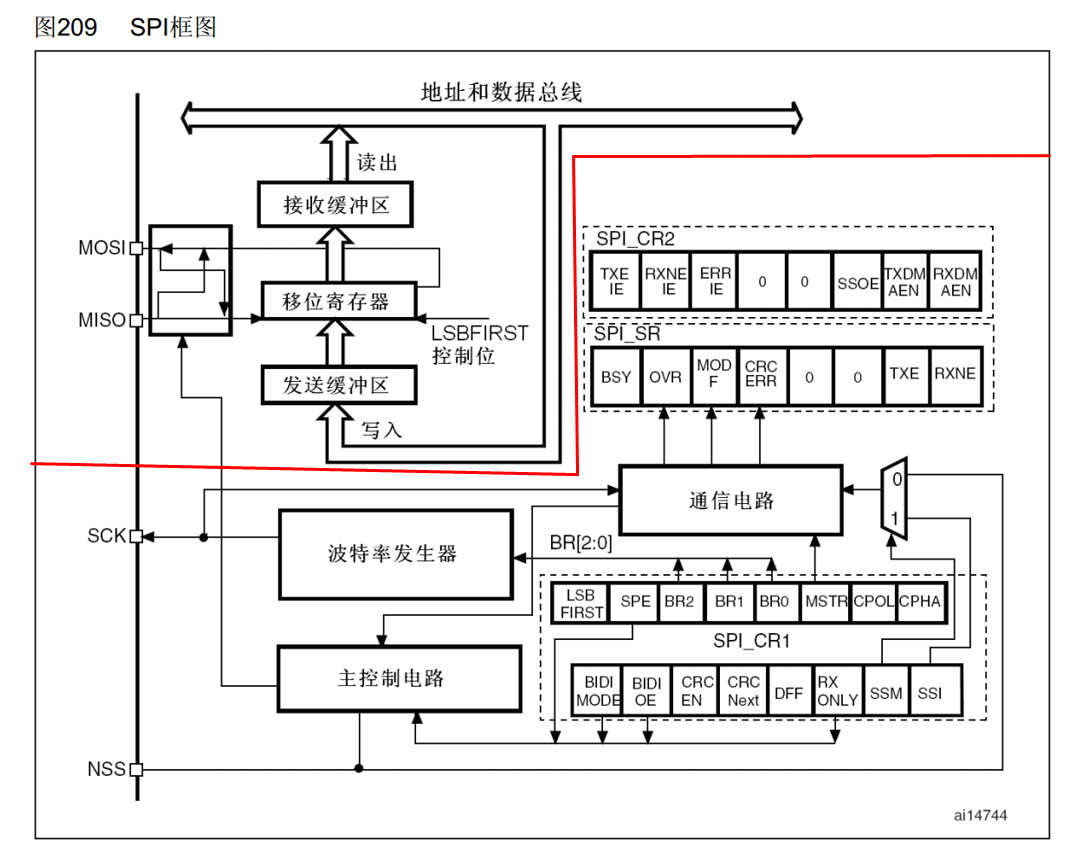
左上角是数据寄存器和移位寄存器打配合的过程,主要是为了实现连续的数据流。
移位寄存器右边的数据低位,一位一位的从MOSI移出去,然后MISO的数据,一位一位地移入到左边的数据高位。(图示是低位先行的状态图)
DR(数据寄存器)分为TDR(发送数据寄存器)和RDR(接收数据寄存器),TDR和RDR占用同一个地址,统一叫做DR,写入DR时,写入到TDR中,读取DR时,数据从RDR读出。比如我们需要连续发送一批数据,第一个数据写入到TDR,当移位寄存器没有数据移位时,TDR的数据会立刻转入移位寄存器,开始移位,这个转入时刻会置状态寄存器的TXE为1,表示发送寄存器空,当我们检查TXE置1后,紧跟着下一个数据就可以提前写入到TDR里候着了。一旦上个数据发完,下个数据就可以立刻跟进。移位寄存器这里,一旦有数据过来了,他就会自动产生时钟,将数据移出去,在移出的过程中,MISO的数据也会移入,一旦数据移出完成,数据移入也完成了,这时,移入的数据,就会整体的从移位寄存器转入到接收缓冲区RDR,这个时刻会置状态寄存器的RXNE位为1,表示接收寄存器非空,当我们检查RXNE置1后,要尽快把数据从RDR读出来,在下一个数据到来之前,读出RDR,就可以实现连续接收。
右下角这一部分,是一些控制逻辑,寄存器的哪些位控制了哪些部分,产生了哪些效果。
波特率发生器就是用来产生SCK时钟的,它的内部是个分频器,输入时钟是PCLK,72M或者36M。
SPI简化框图
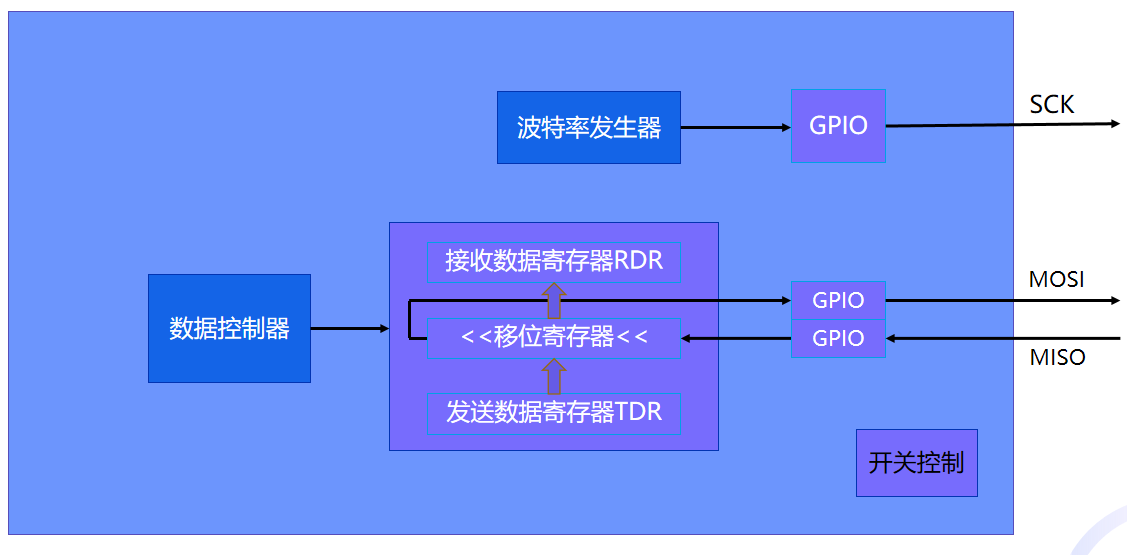
SPI运行控制
主模式全双工连续传输
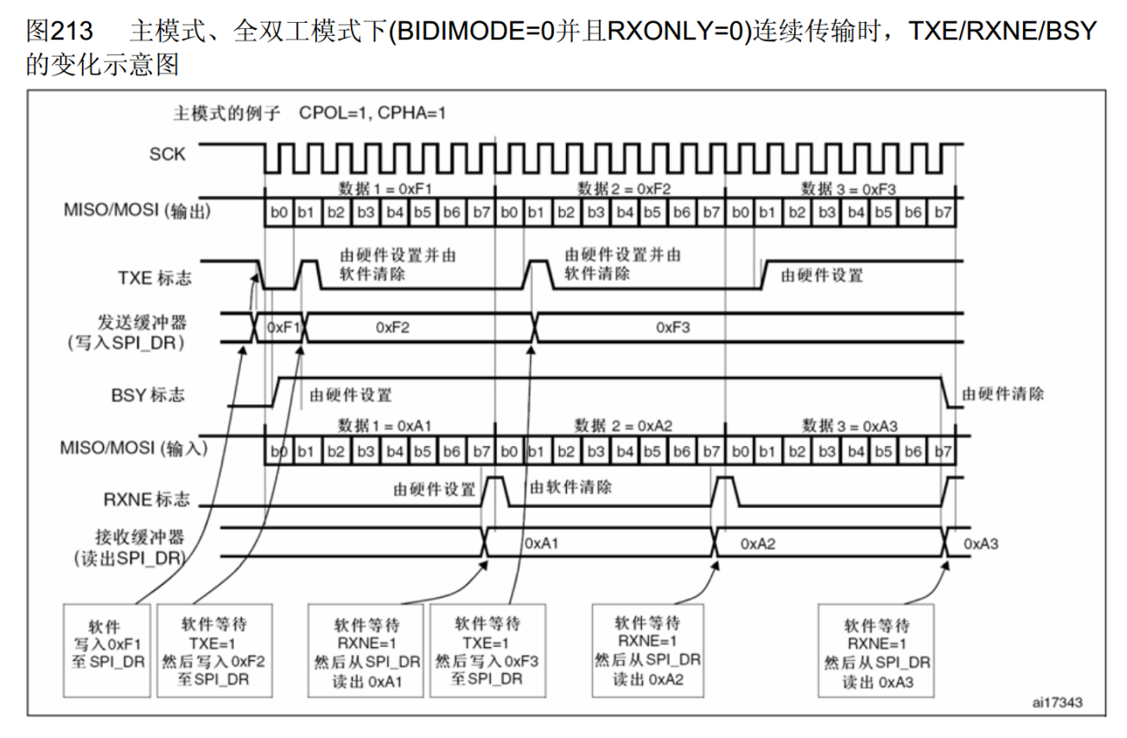
第一行是SCK时钟线,CPOL=1、CPHA=1代表示例使用的是SPI模式3,所以SCK默认是高电平。在SCK的第一个下降沿,MOSI和MISO移出数据,之后上升沿移入数据。
输出:
第二行是MOSI和MISO输出的波形,跟随SCK时钟变换,数据位依次出现,这里从前到后,依次出现的是b0、b1,一直到b7,所以示例演示的低位先行的模式。
第三行时TXE,发送寄存器空标志位。
第四行是发送缓冲器(写入SPI_DR),实际上就是TDR。
第五行是BSY,BUSY,是由硬件自动设置和清除的。当有数据传输时,BUSY置1。
输入:
第六行是MISO/MOSI输入数据。
第七行是RXNE,接收数据寄存器非空标志位。
第八行是接收缓冲器(读出SPI_DR),就是RDR。
可以看到它整体的流程并不是我们想象的那样,发送数据1,接收数据1,发送数据2,接收数据2…这样规则的,而是交叉的,发送数据1,发送数据2,接收数据1,发送数据3,接收数据2,发送数据4,接收数据3……实际上是这样交叉进行的。对我们程序的设计不太友好。
非连续传输
非连续传输对程序设计非常友好,只需要4行代码就可以完成。
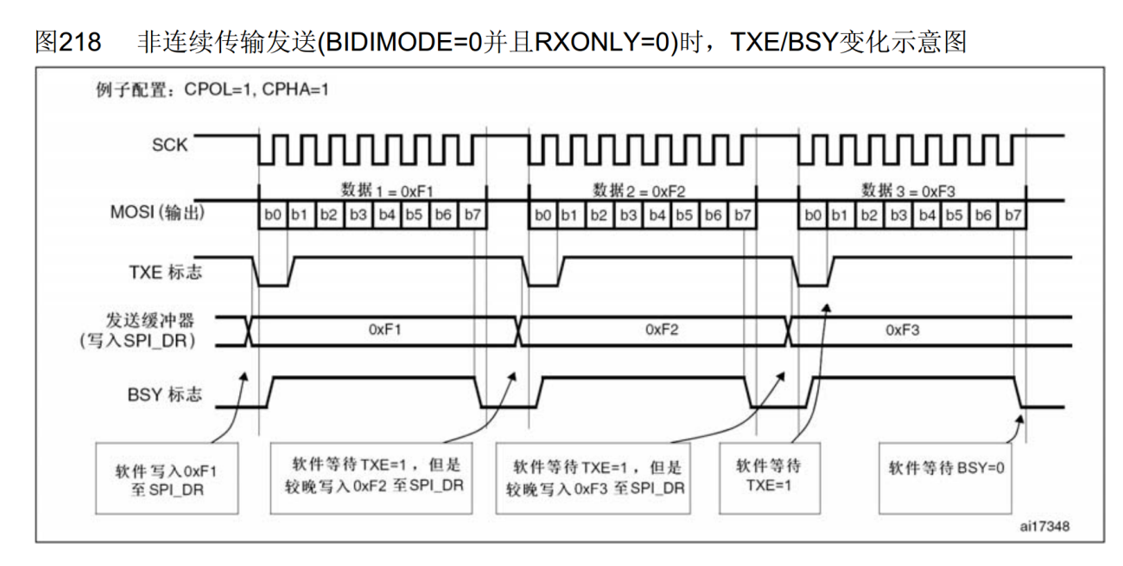
配置还是SPI模式3,SCK默认高电平。
我们想要发送数据时,如果检测到TXE=1了,TDR为空,就软件写入0XF1至SPI_DR。这时TDR的值变为F1,TXE变为0。
在非连续这里,TXE=1了,发送寄存器空了,但是我们不着急把下一个数据写进去,而是一直等待,等待第一个字节时序结束,第一个字节结束时,RXNE会置1,我们等待RXNE置1后,先把第一个接收到的数据读出来,之后再写入下一个字节数据。
整体步骤就是:
1.等待TXE为1。
2.写入发送的数据至TDR。
3.等待RXNE为1.
4.读取RDR接收的数据。
5.交换第二个字节重复上面4步。